IT之家5月28日消息,腾讯混元宣布正式推出Hy-Memory。据介绍,这是一个专门为Openclaw这类长期协作型Agent设计的记忆插件,能真正成为Agent的“第二大脑”。
官方称,Hy-Memory用6层记忆框架×System1/System2双系统×演化链三层底牌,让Agent在长期使用中真正"记得住、记得对、记得轻、更懂你"。
在权威公开测试集上,Hy-Memory效果超过现有主流memory框架,可以解决记忆碎片化问题,记忆数量低70%+,每条记忆信息密度高45%+。在处理超长上下文方面,Hy-Memory消耗的token量降低35%,记忆更新速度快20%。
IT之家附官方详细介绍如下:
Agent任务对长期记忆的要求远超Chat
使用Agent和Openclaw深度用户,常常描述过一种常见的“三周轨迹”。
第一周:蜜月期,把自己当下正在忙的事情,比如一个项目的来龙去脉、最近的决定和取舍、未来想做的方向一股脑都告诉Openclaw。,能回答问题、能查资料、能帮你规划、能写代码、能起草文档。“这玩意儿真好用”——这是大多数人第一周的真实感受。
第二周:开始不安。人们注意到每天打开Openclaw都得先花3到5分钟提醒它我们在做什么。它好像不太记得几天前讨论过的判断。当你对它说“按之前那个方案”,它会反问“哪个方案”,说“那个我们排除掉的选项”,它却想不起来排除的是什么、为什么排除。不是完全不记得。Openclaw默认的记忆机制能记住一些最近的对话原文,但跨天、跨Session、那些更深的判断,它就漂移了。
第三周:主动降级使用,开始下意识地缩短跟它讨论的深度。不再问“这个方向我该不该走”,因为知道明天它就忘了。变成只问最具体、最即时的小问题:搜个资料、查个语法、改一段文字。
最常见的结局是,Openclaw在使用者眼里,慢慢从“能陪你思考的伙伴”,降级成了“一个查询工具”。这不是Openclaw的问题——它的内核能力一直很强。问题在于:长期协作类任务对长期记忆的要求,远超过普通Chat。
Hy-Memory这个Openclaw记忆插件的初衷,就是为了把这三周轨迹的后两周抹掉——让用户第一周怎么用Openclaw,第三个月还能怎么用,而且越用越懂。
1、长期任务对记忆的挑战比想象中难
长期任务跟普通Chat完全是两种工作。不管你拿Openclaw调研一个复杂决策、写一本书、规划一次大旅行、跟进一个跨季度的项目,一次对话可能30轮50轮100轮,中间不停地查资料、调工具、读文档、出方案、回退、再改、再走,一个Session可能持续几个小时,任务可能跨越数周。
记忆系统至少要扛住4件事:
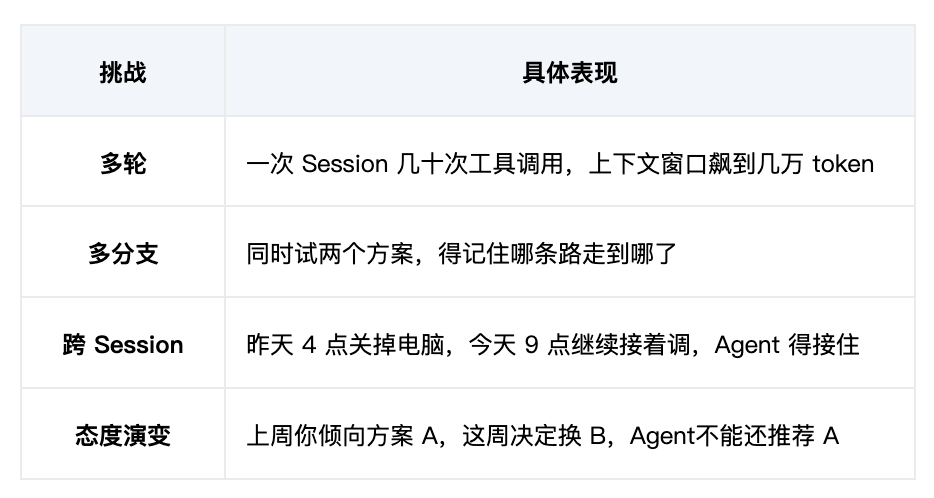
任何一个环节崩了,体验就崩了。
2、一个合格的Openclaw记忆插件要满足的3条标准
我们在设计Hy-Memory的时候围绕“什么样的记忆插件才配得上Openclaw这种长期协作场景”,定了3条硬标准。
标准一:不能丢历史。
用户跟Agent聊过的所有“为什么选这个、为什么否那个”——这些判断和因果不能丢。否则下次它推荐方案,可能直接推荐回用户已经否过的那个,白费时间。
标准二:要能演化。
人不是一个静态的存在。技术偏好、生活习惯、长期目标都会随时间变,对某件事的看法也会反复调整,这些都得被记住。不是覆盖式的“只记最新”,也不是堆积式的“全都留下”,而是要有一个清晰的演化轨迹。
标准三:要在主链路里不仅足够快,还要有认知迭代,进化。
记忆插件不能拖慢用户当下打字、调用工具、等结果的速度。每次搜索要在毫秒级,召回也不能成为响应瓶颈。同时还要有深层次的语义和事实理解。
接下来,我们把Hy-Memory满足这3条标准的三层底牌分别讲清楚。
Hy-Memory的三层核心
第一层:6层记忆框架——给每种记忆找到正确位置
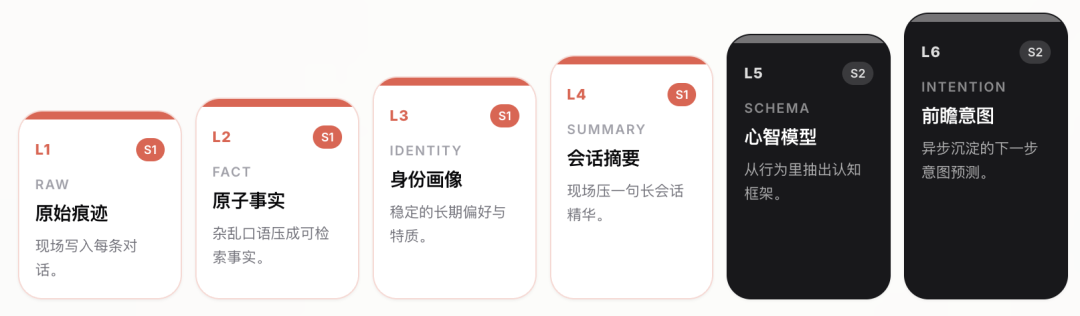
Hy-Memory做的第一件事,是没有把所有记忆塞进同一张表。
想一下——用户跟Openclaw聊到最近在准备出国留学,这段话里其实混着好几种东西:
·“我在准备出国留学”——这是事实
·“我偏好北欧那种慢节奏的项目”——这是画像
·“我做大决策前会先列利弊清单”——这是心智模型
·“我下周大概率会问推荐信怎么找教授”——这是前瞻意图
这些东西信息形态完全不一样,但传统记忆系统会把它们全揉成一堆向量,搜索时一锅捞。Hy-Memory把记忆分成6层,每层一种职责。下面用一组多领域混合的例子,让你感受Agent“记的是什么”:
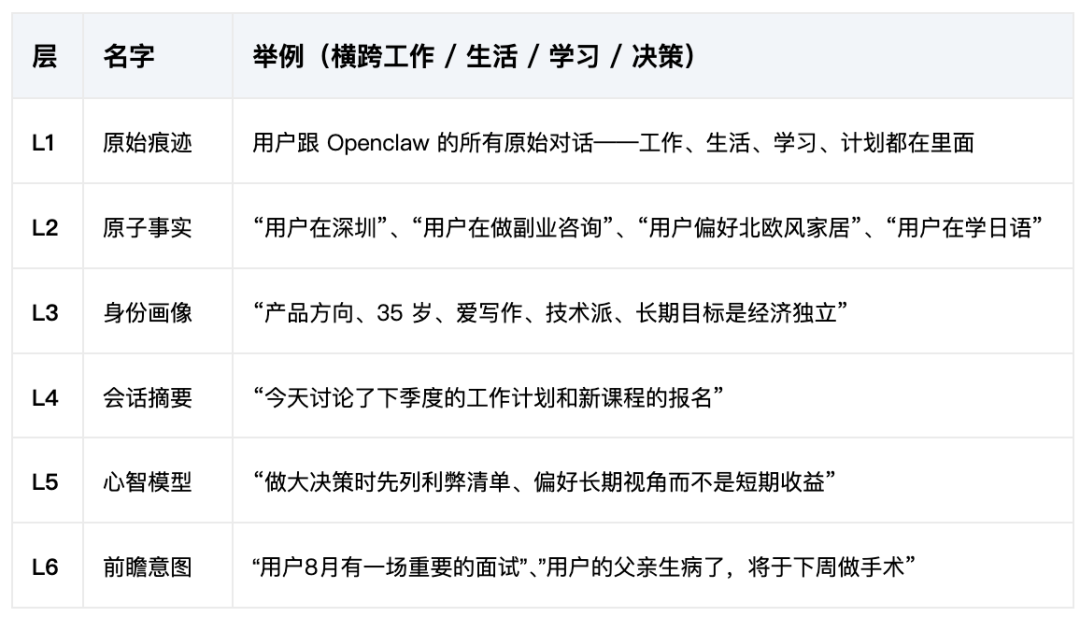
用户问Openclaw“我做大决策有什么习惯”,它应该优先看L5心智模型,而不是把过去100轮对话原文一锅塞过来。用户问"我现在住在哪",L2一条事实就够了。问什么、走哪层、用什么样的检索权重——分层让这些都变得可能。
整个prompt会变干净。模型的注意力不再被无关原文稀释。
第二层:双系统设计,既保障速度又具备认知迭代
Hy-Memory把来自人脑认知科学的System1/System2机制直接复刻到了Agent的记忆加工上——就像给Openclaw装了一颗符合认知科学的"大脑"。
Hy-Memory把记忆加工拆成两套。
System1(白班):用户回车那一秒,实时地处理写入的记忆。负责写原始痕迹、抽事实、更新画像、压会话摘要——也就是L1–L4
System2(夜班):秒到分钟级,在后台跑。负责抽心智模型、构建知识网络、预测意图——也就是L5–L6
为什么要拆?因为深度认知很慢。抽你的“决策心智模型”、构建你的“知识网络”——做完一遍LLM可能要5到20秒。如果让你每次调用Openclaw都等20秒才能收到回复,谁都用不下去。
但你要的也不仅是“快”——你要的是Agent越用越懂你。Hy-Memory的拆分把这两件互相打架的事变成两条独立通道:
1、发送消息后System1已经把“立即可用的记忆”写好了——下一句对话能立刻用上
2、System2在后台慢慢做更深的认知——把你两周的对话沉淀成“你的决策心智”
结果在对话最直接的影响:你每次说完的信息它能立马记住;而它对你的理解还在后台不断变深。
第三层:演化链——记忆能改写但不丢因果
第三层是Hy-Memory真正的杀手锏,也是我们觉得用户长期跟Agent协作时最容易踩坑、也最值得做对的一件事。
一个典型的长期场景:假设一位用户跟Openclaw聊了大半年自己的健身计划。过去半年里他的训练方式发生过4次明显的态度转折:
·去年春—开始跑步训练有氧,效果不错,体重和精神状态都改善了,对跑步充满信心
·去年夏—跟练HIIT,强度太大,膝盖出了问题,被迫停训两周
·去年秋—转向纯力量训练,只练大重量、放弃了心肺,结果跑两公里都喘,挫败
·上月—形成「力量+慢跑+瑜伽」混合方案,身体状态终于稳定下来
今天他打开Openclaw问它:“我下个月想再加一种新的训练方式,你建议什么?”
三种记忆系统会给出三种答案。
答案1:覆盖派(只记最新)
很多默认记忆系统是“用新覆盖旧”。库里只剩“用户当前用混合训练效果好”。
Agent的回答:“你现在的力量+慢跑+瑜伽组合挺好,可以再加一个CrossFit试试,效率高。”
不算错,但很浅。它不知道用户为什么走到混合训练——错过了“HIIT伤过膝盖”、“纯力量丢了心肺”这条完整的踩坑路径。直接推荐CrossFit很可能让用户再伤一次膝盖。
答案2:堆积派(全部保留)
另一些系统是“什么都留下,搜索时按向量相似度召回”。库里4条事实都在,但搜索“新训练方式”时,最近的、最相似的先被召回——大概率是“跑步起步效果不错”和“混合训练稳定”。
中间的“HIIT膝盖受伤”、“纯力量丢心肺”在语义空间里距离稍远,可能根本召不回。
Agent的回答:“你跑步效果不错、混合训练也稳定,可以加一个HIIT试试,提升心肺效率高。”
踩雷了。它没意识到用户已经在HIIT上受过伤——重新推荐HIIT等于让用户再走一次老路、再伤一次膝盖。
答案3:Hy-Memory演化链
Hy-Memory在写入第2条记忆时,会用supersedes指针指向第1条;第3条指向第2条;第4条指向第3条。4条记忆通过指针串成一条链。D(混合训练,链头)↓supersedesC(纯力量,丢心肺)↓supersedesB(HIIT,膝盖受伤)↓supersedesA(跑步起步)用户问“新训练方式选什么”时,搜索命中链头D,整条链自动展开——A、B、C、D一起返回给Agent。
Agent拿到的不再是孤立结论而是完整的态度演变:
●跑步起步→
●HIIT伤膝盖→
●纯力量丢心肺→
●混合方案稳定下来
它的回答会是这样:
“你之前在训练方式上走过完整的路:跑步起步、HIIT伤过一次膝盖、纯力量又丢了心肺,上月才走到力量+慢跑+瑜伽这个稳定组合。
所以新方式我会建议你避开高冲击的爆发类训练(比如CrossFit、HIIT这类)——你的膝盖已经踩过一次坑。如果想再加新内容,可以考虑游泳或骑行这种低冲击有氧,或者爬山/长距离慢跑——都比再回HIIT安全。”
这个回答的质量,不是来自模型本身,是来自记忆结构。
演化链的本质
技术上演化链做的就是两件事:
1、新记忆写入时,通过supersedes指针指向旧记忆,形成一条链
2、搜索命中链上任意一节点,自动展开整条链
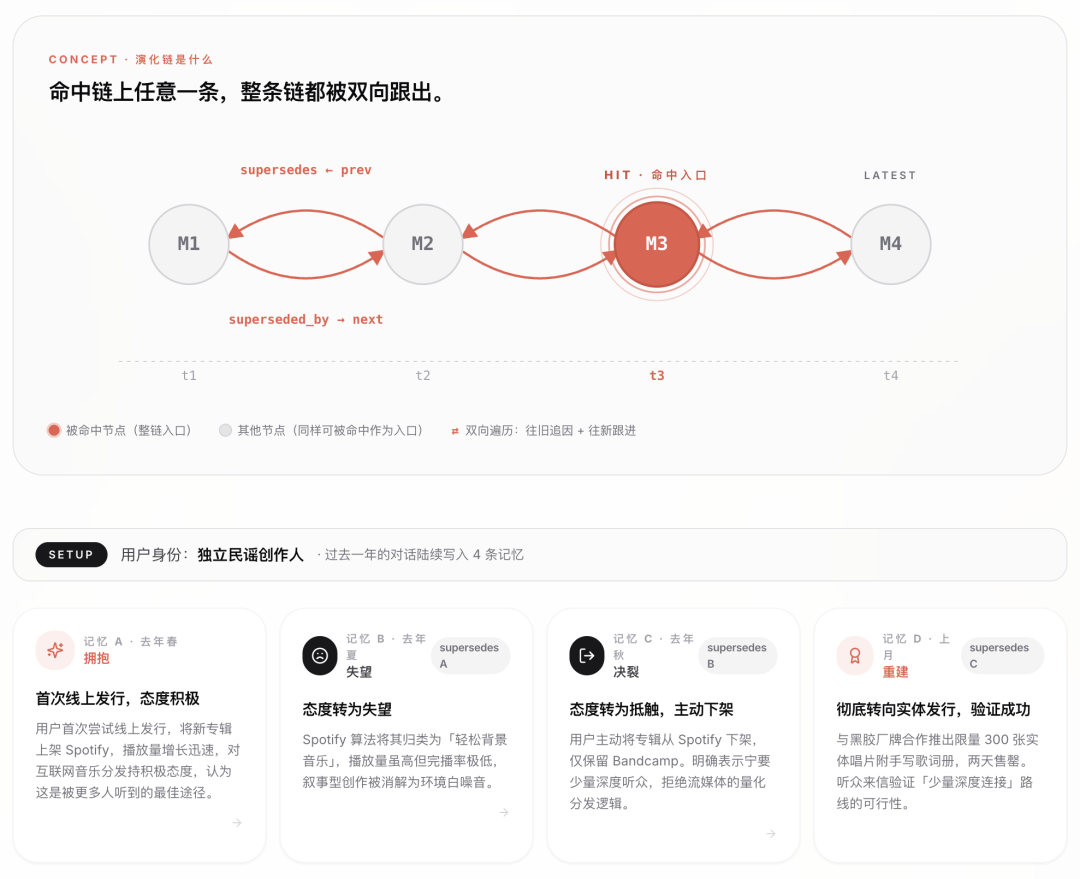
最新的判断在最前面(链头),但被否过的、被替代的、被废弃的旧版本不会丢——只是退到链身后面,需要时随时展开。这是我们能想到的、最适合Agent长期陪伴用户的“长期记忆”形态。
Hy-Memory:超过同类框架
Hy-Memory在LongMemEval和PersonaMem这两个权威的长期记忆评测上跑过。
1、LongMemEval:得分达85.2,远超其他框架。LongMemEval是公认很难的长期记忆评测,500道题覆盖6个能力维度。
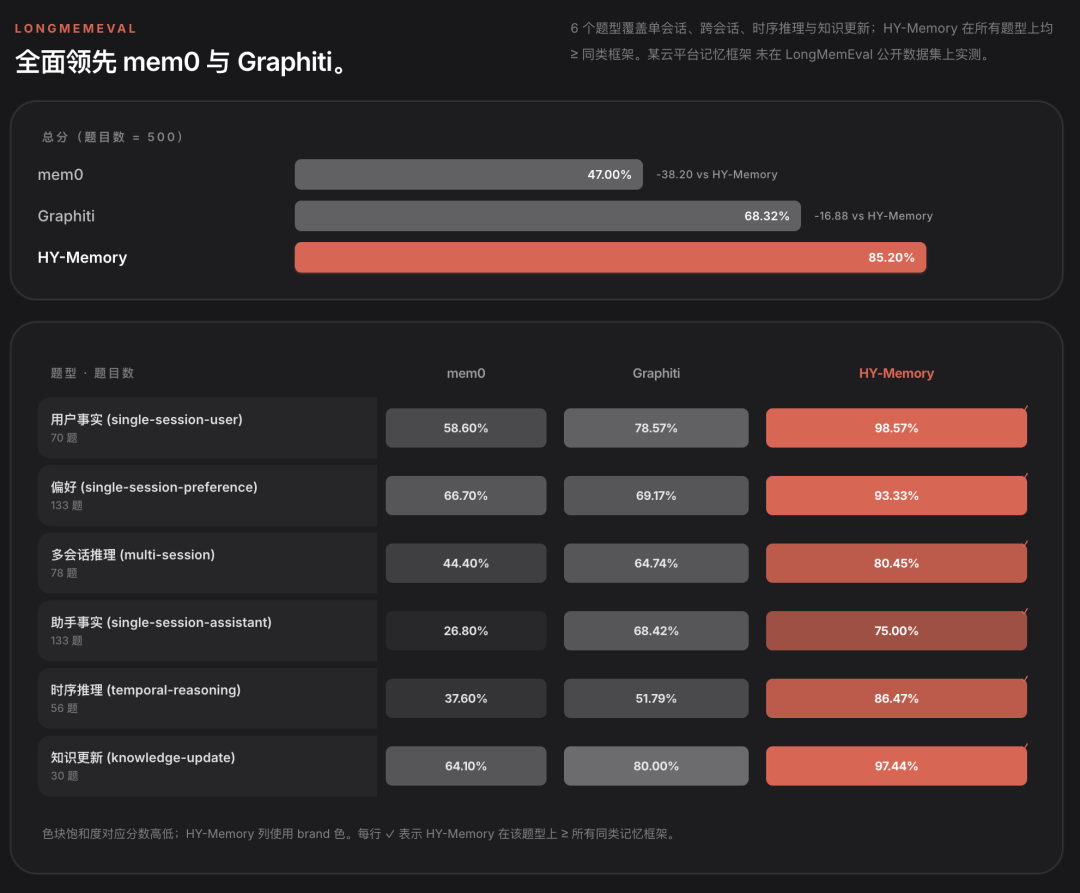
Hy-Memory不仅打赢所有同类系统,在6个维度中的4个维度取得最高分——尤其在最考验"演化能力"的偏好(+21.11pp)、时序推理(+9.63pp)、知识更新(+21.37pp)三项上领先同类产品。
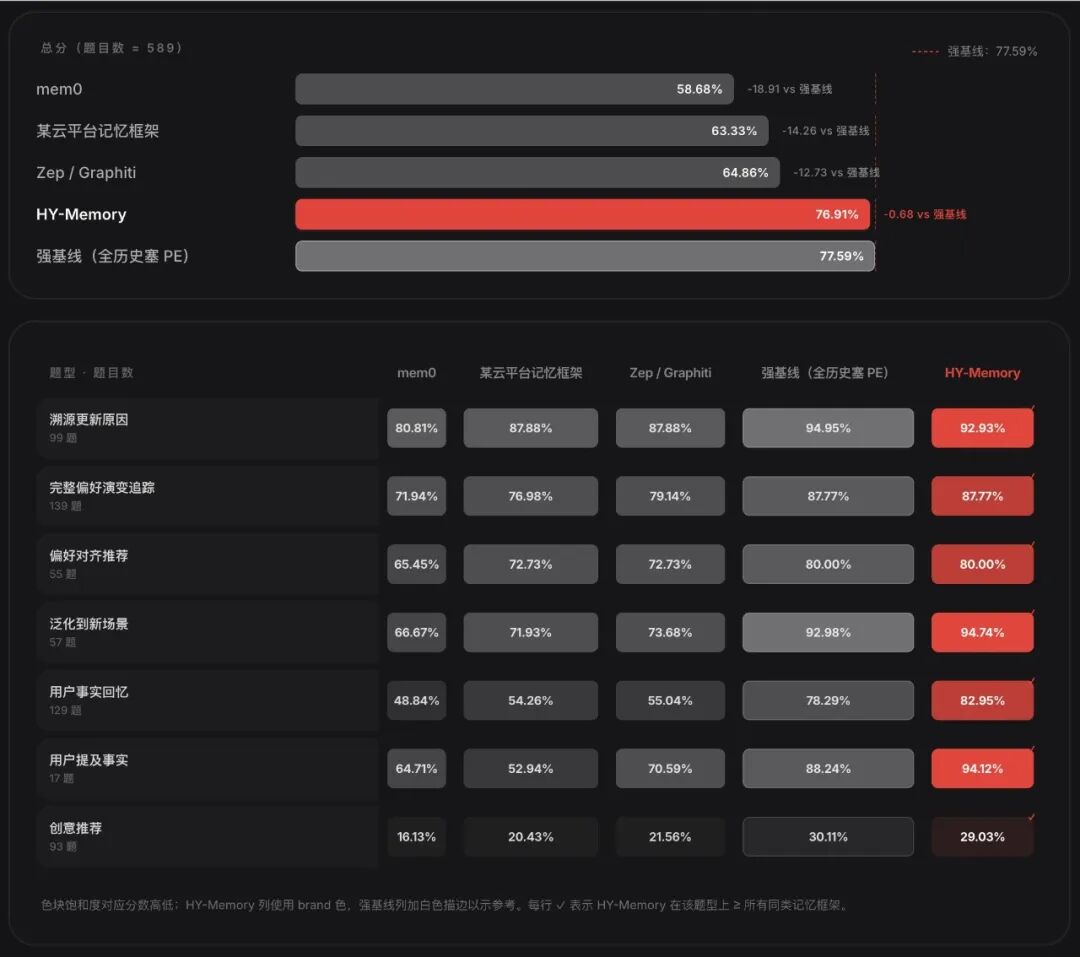
2、PersonaMem:打赢所有同类产品,PersonaMem是6000+条消息/589道题的真实长期对话评测,更贴近"用户用了好几个月"的真实场景。
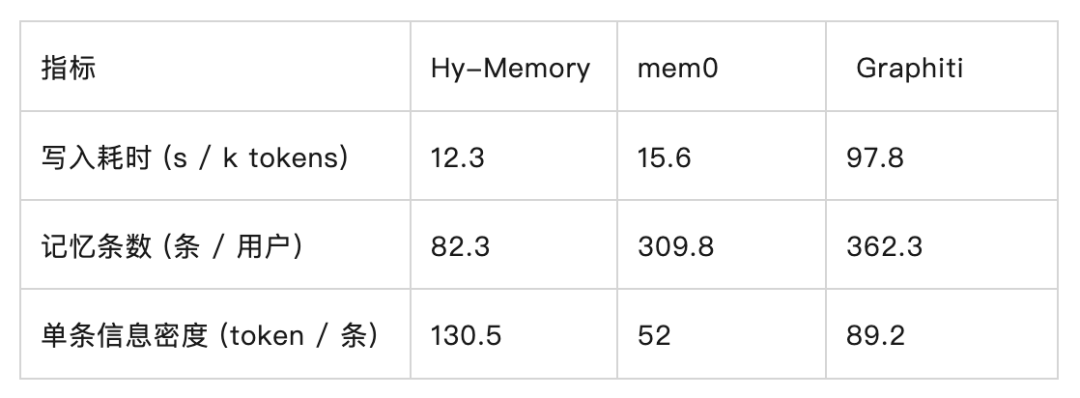
3、性能:有更高的记忆密度同时,更有8倍写入速度
Openclaw用户能感受到的是:
·写入快:跟mem0同档,是Graphiti的8倍快,不会卡Openclaw的对话主链路
·存得少:记忆条数只有mem0的1/3、Graphiti的1/4–1/5,本地嵌入式存储,不需要外部服务,内存占用低
·密度高:单条记忆是mem0的3–4倍信息密度,每次召回的记忆更管用,prompt不被噪声污染
最后这条对长期任务特别重要:当一次Session跑到80轮对话,召回的每一条记忆都得是高密度的,否则prompt一下就被噪声塞爆,模型注意力被稀释。
Hy-Memory的高密度意味着同样的Token预算下Openclaw能看到比别的记忆系统多3-4倍的有效信息。
本文内容由互联网用户自发贡献,该文观点仅代表作者本人。如发现本站有涉嫌抄袭侵权/违法违规的内容,请发送邮件至 203304862@qq.com
本文链接:https://jinnalai.com/jiaodian/833328.html

